一份上百页的扫描报告,打开能看,想复制其中一段却选不中字
把页面转成文字还只是开始 表格翻到下一页,表头和数据要接上;一段话被分页截断,导出来也得读得通
百度在 10 月 27 日发布的 Unlimited-OCR 2,关注的就是这类长文档处理 它尝试让模型持续识别页面,同时控制识别过程中不断积累的记忆负担
名字里的 Unlimited 容易让人联想到随便扔一本书进去 要理解它的价值,先得分清模型改进了什么,以及现在能从哪里用起来
认出每一页,还要把前后接起来
把图片中的文字识别出来,这类技术叫 OCR 手机拍照提取文字,就属于常见用法
但一整份报告比单张照片多了一个问题,页面之间有关系
比如一张设备清单,上半部分在前一页,下半部分在后一页 如果逐页处理后直接拼接,可能得到两张分开的表,也可能把重复出现的表头混进数据
Unlimited-OCR 2 提供多页一起解析的方式,让模型在处理时利用前后页的信息 这给跨页段落和表格的衔接提供了条件,结果是否接对,仍要核对
对读者来说,值得关心的是能否少做一轮手工拼接,让扫描材料成为后续搜索、摘录和整理的起点
工作台有限,怎样继续往后读
一些生成式识别模型会一边看页面,一边写出结果,同时保存已经处理过的信息,供后面参考
文字输出越长,这些临时记忆也可能越积越多,增加显存占用,拖慢后续生成
可以把它理解成抄录厚报告 如果每抄完一页,都要把越来越厚的历史记录摊在桌面上核对,工作台就会越来越挤
Unlimited-OCR 2 用到的机制叫稀疏参考滑动窗口注意力 按模型说明,它把长序列中的文字与视觉信息交互,收束到一组大小受控的工作参考中
借用工作台的比喻,就是围绕眼前的内容继续处理,把需要参考的信息控制在有限范围内 已经写出的文档仍然保留,不需要为了继续识别,把所有历史细节都放在工作台上
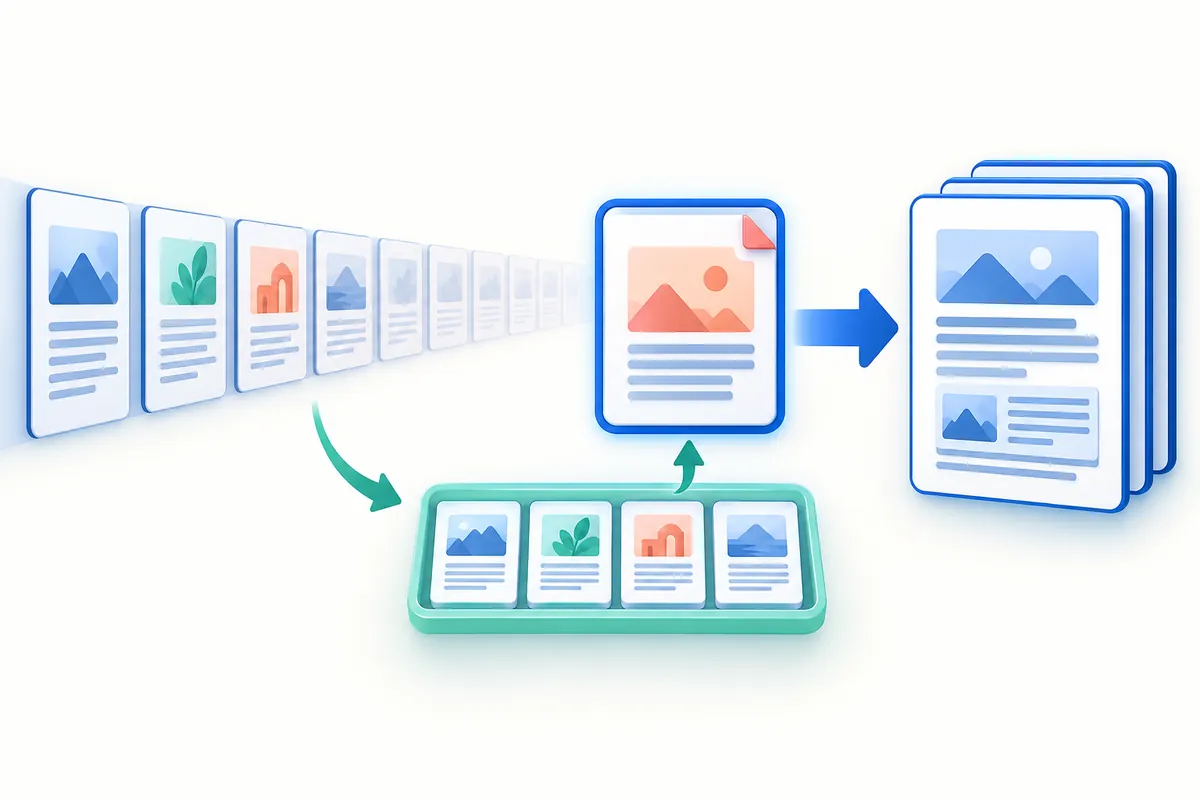
示意图用有限的参考卡片解释工作记忆,输出文档仍可以继续增长
这项改进针对的是识别过程中的记忆和计算负担 读取图片、处理页面、保存结果都要消耗资源,整份文档越长,总处理时间也不会凭空消失
百页测试,不能只看一个总分
团队同时公布了 MarathonDocBench,用 100 份百页级文档测试长文档解析,材料包含中英文,也有密集的跨页文字和表格
这个测试提供了一种观察角度 判断模型是否适合厚报告,除了看字认得对不对,还要看阅读顺序、表格结构、标题层级和跨页衔接
不过,榜单结果来自项目方公布的评测 其中部分对比模型会受到一次请求可接收图片数量、请求体大小或输出长度的限制,失败文档也计入结果
因此,排名同时反映了整套处理方式能不能承受长文档,不能直接理解为每一页的识字准确率差了同样多 手上的中文小字、模糊扫描和复杂表格,仍需要单独验证
网页可以试,但一次只收 20 页
普通读者可以先打开仓库链接的在线演示,使用公开材料尝试解析,再查看结果或导出 Markdown 文件
截至本文写作,演示页面写明每次请求最多处理 20 页,超过会截取前 20 页 它用于小规模测试,没有启用支持超长文档的解码流程
要处理真正的长文档,需要按项目文档部署配套服务 模型和代码采用 MIT 许可,但它还不是下载后双击就能用的桌面软件
官方列出的基础测试环境使用 NVIDIA A800 80GB 显卡 这不等于最低配置必须如此,也不能据此承诺普通笔记本能够顺畅运行
部署还有取舍 文档说明,缩小一次处理的页面窗口可以降低内存峰值,却可能影响窗口边界处的跨页合并 省资源和保留前后联系,需要用实际材料找平衡
先拿一张跨页表格判断值不值得用
学习资料可以先选连续几页,检查上一页末尾的句子能否接上下一页,再把确认过的文字整理进笔记
行业报告可以挑一张跨页表格,核对表头、单位和行列关系 长期整理档案的团队,则可以选几份固定版式材料,评估解析加复核是否比手工处理省事
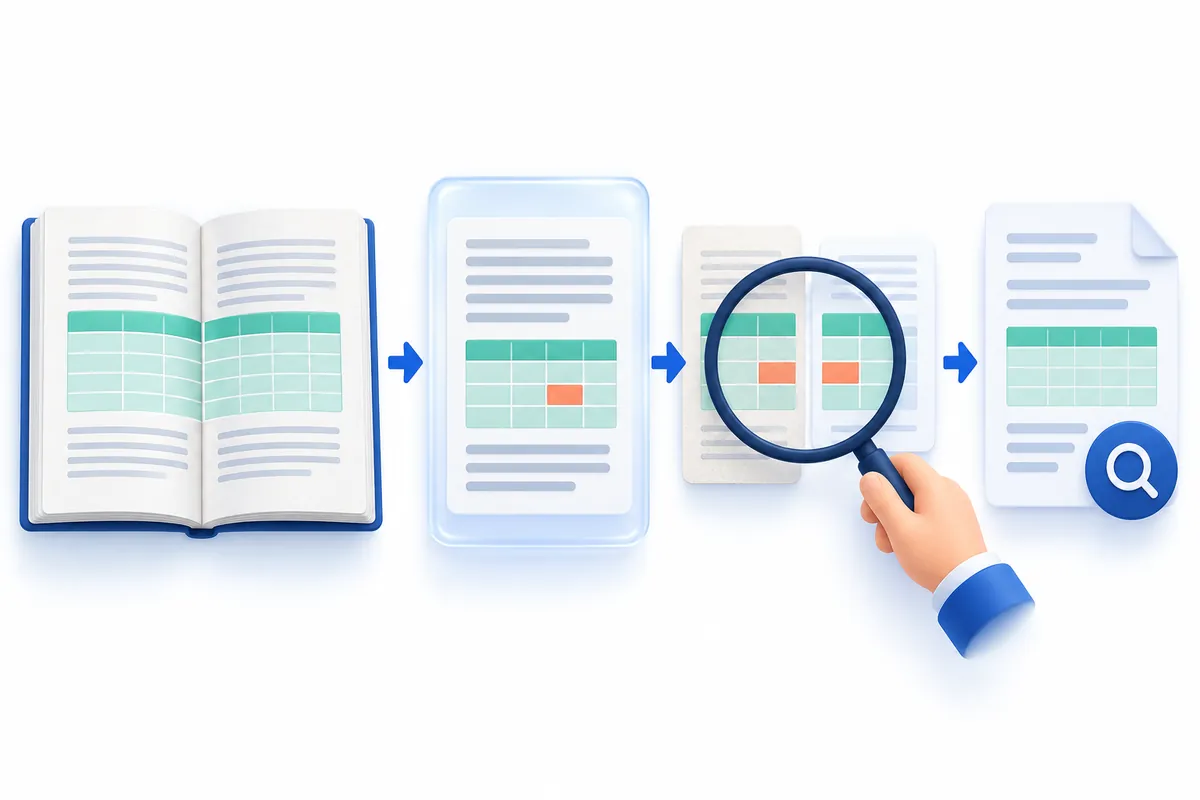
先解析,再对照原页检查数字与结构,确认后再用于搜索和整理
试用时尤其要看数字、负号、小数点,以及跨页后有没有漏行或重复行 在线演示会把文件交给远端服务,先用不含私人信息的公开材料即可
长文档识别的进步,最终要落到那份厚报告上 先把一张原本需要手工拼接的表格处理好,再考虑扩大到整本材料,比看到 Unlimited 就上传全部文件更有判断依据