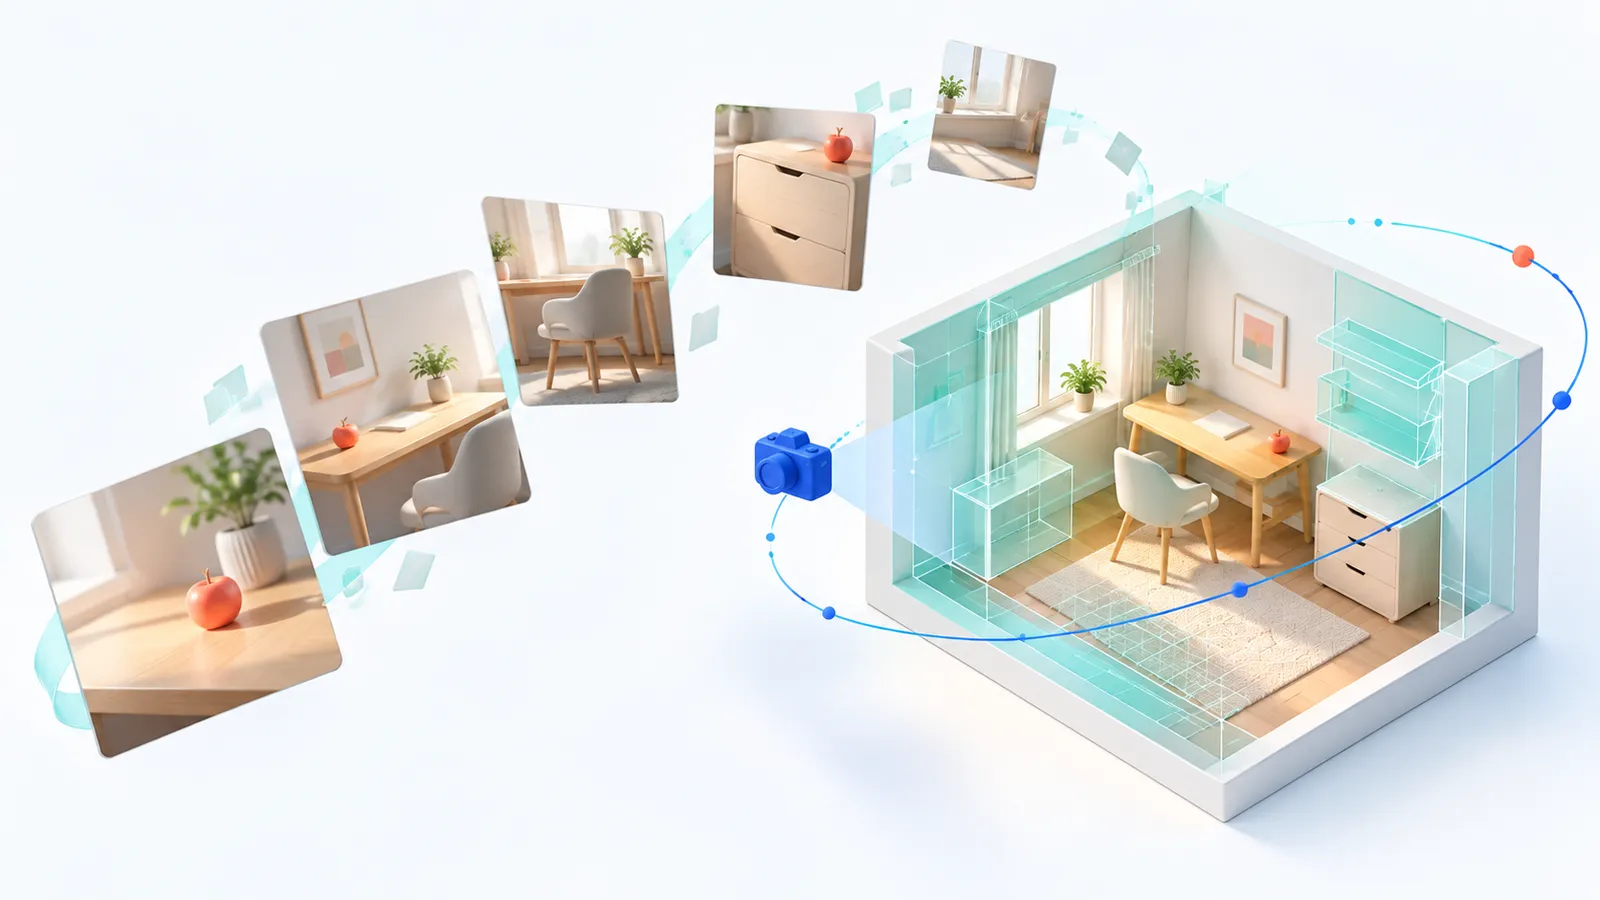
拍下书桌、椅子和抽屉,接下来能做什么?除了保存照片、让 AI 描述房间,现在还有一种尝试,让电脑重建这个空间,再拉开抽屉、推动椅子,看看里面会发生什么
Mundo 就在做这件事,它根据一个地方的照片搭建可修改、可模拟的环境,再把模拟过程生成视频
它展示了一条值得关注的路线,让 AI 生成画面之前,先给画面里的东西安排位置、运动规则和变化过程
先搭一个房间,再决定里面发生什么
项目团队在 10 月 23 日的技术介绍中,展示了从照片重建环境、移动视角和模拟物体交互的方法
理解它可以从搭舞台开始
先用简单的方块确定桌子、椅子和柜子在哪里,再给需要运动的物体补上形状、质量和摩擦等信息,交给物理模拟程序计算,最后让视频模型依据原始照片,把过程画出来
比如拉开一个抽屉,系统需要知道抽屉朝哪边移动、里面的物体怎样受力,生成画面时还要保留这个房间的外观
这几个环节分工不同,照片提供外观线索,三维场景记录空间关系,模拟程序计算运动,视频模型负责呈现结果
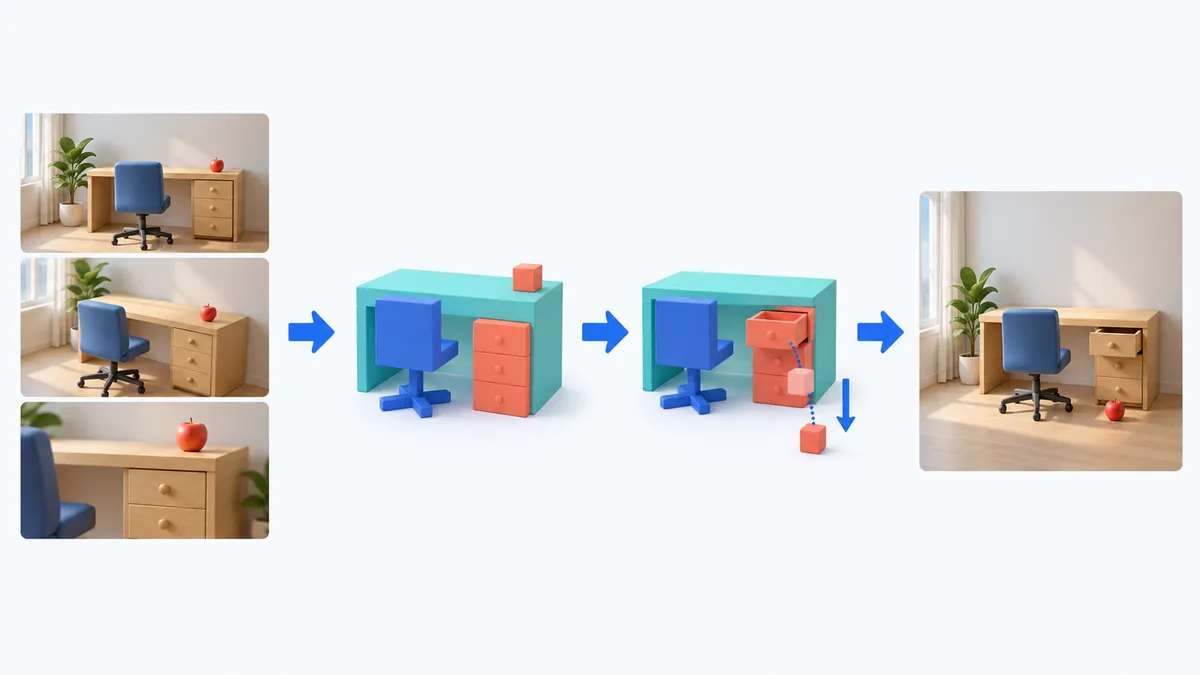
从照片、简化场景到模拟与画面,概念示意
这种能表示环境、并推演环境变化的系统,通常被称为世界模型,Mundo 关注的是把这种能力落到照片里的具体地点
它的意义在于,房间里有什么、东西摆在哪里,可以成为后续操作共同使用的依据,镜头移动和物体运动便有了可以检查、修改的基础
照片看不见的地方,AI 仍然要猜
一张书桌的正面照片,无法告诉你桌子背面有几根线,也拍不到柜子后面藏着什么
Mundo 可以补出新的视角,但生成出来不等于那里确实如此
项目页面提供了同一场景使用一张、三张和九张参考图的对照,增加视角能补充证据,减少模型需要自行推测的部分
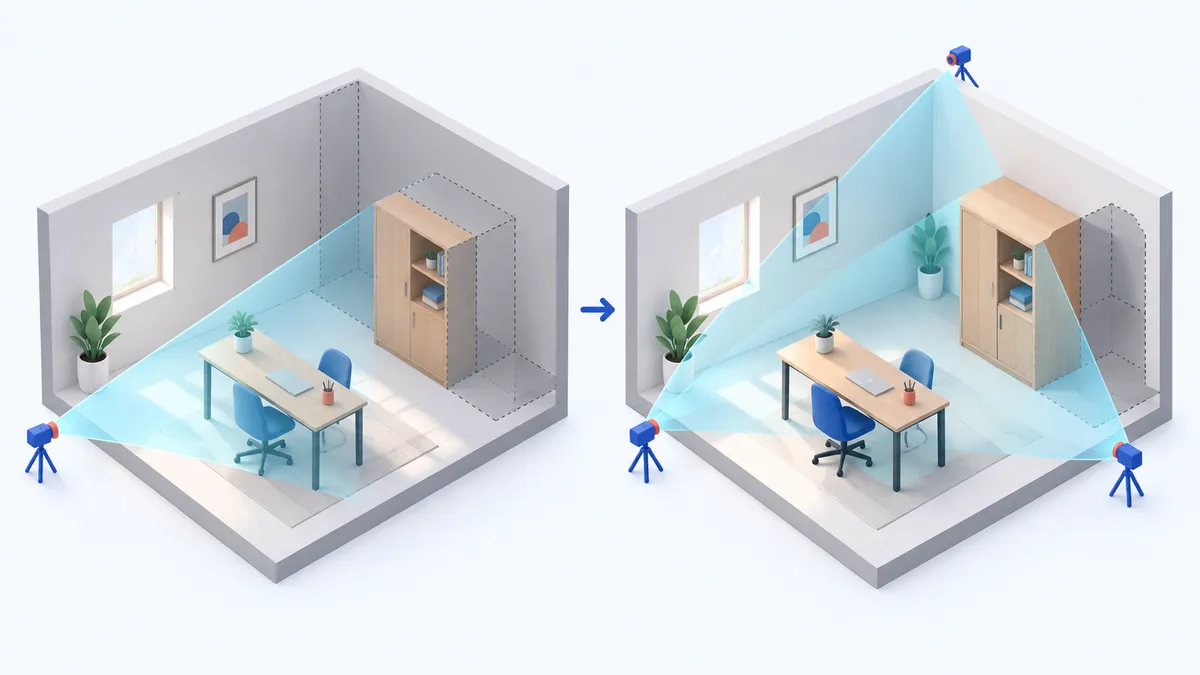
多拍几个角度能减少未知区域,概念示意
物理信息也有同样的问题,照片能帮助判断物体的外形,却无法可靠地称出柜子的重量,或测出地板的摩擦系数
因此,模拟结果取决于填入的条件,画面看起来顺畅,并不能证明里面每个参数都符合真实房间
这会影响你怎样使用结果,看一段镜头怎样穿过房间,可以帮助理解空间;拿它判断家具承重或碰撞安全,就需要额外测量和验证
从看房间,到让机器人先走一遍
最直观的用途是空间预览,沿着设定路线观察一个房间,看看从门口走到床边会经过什么,项目已经展示了这类视角移动
对普通读者来说,这提供了一种理解照片的新方式,几张分开的画面可以被组织成连续空间,但不能代替实地查看和尺寸测量
另一个方向是创作预演,把物体移动、镜头绕行和时间暂停组合起来,先看一段动作如何呈现,再决定是否值得继续制作
这是根据它的编辑与渲染能力可以延伸的用途,离顺手的日常创作工具还有距离
更靠近项目当前研究目标的是机器人测试,先把真实环境搬进模拟空间,让机器人在里面规划路线、尝试操作,再观察过程
团队展示了酒店楼层导航和洗衣房相关场景,其中的生成画面与模拟演示,并不证明机器人已经在真实地点完成同样的任务
这类方法的价值,是为测试提供一个可反复修改的环境,至于在里面练出的行为能否搬到现实,还要另外检验
现在适合看演示,还不适合急着装
截至 10 月 26 日,项目仓库仍将代码与权重列为计划在 11 月底提供的内容,不能因为有 GitHub 页面,就把它当成已经完整开放、能下载运行的软件
速度也是门槛,团队披露的场景重建通常需要十到二十分钟,在八张 A800 显卡、二十步生成设置下,视频渲染约为每秒一点五帧
这里说的是生成速度,离一边拖动物体、一边即时看到完整视频还有距离
小物体交互可能出现漂浮或画面错误,长时间变化之后,场景细节也可能前后不一致,现阶段更适合研究和技术演示
想了解它,可以从官方演示页面开始,先看同一个房间在不同视角下是否保持一致,再对照简化场景与生成画面,观察物体运动有没有对应起来
拍几张照片就能进入一个可模拟的房间,这件事已经有了可展示的样子,接下来决定它能走多远的,是这些模拟能否经得起现实的核对