一封客服邮件进来,系统要判断它该去退款组、物流组,还是交给人工处理
过去,开发者通常会写一堆规则,或者让一个通用大模型读完邮件,再从一段文字里解析它的结论。规则容易漏掉没想到的表达,大模型则可能答得很流畅,却不按程序需要的格式回答
TypeSafe AI 最近发布的 Jev,试着把这一步单独做成一个模型。它不负责写回复,也不和用户聊天,而是从给定的选项中作判断,再把选择和对应概率交给软件
这听起来像是让 AI 少做一点事。Jev 的看点恰恰在这里:软件里有很多环节不需要一段漂亮的回答,只需要一个足够可靠、能被程序接住的判断
模型不必每次都写一段话
通用大模型最熟悉的工作方式,是根据输入继续生成文字。你问它一封邮件该由哪个团队处理,它可能会解释理由,再给出一个分类结果。对人来说,这样的回答容易读;对程序来说,还要再把文字解析成一个字段,处理格式错误和模棱两可的情况
Jev 把问题改成有限的判断。开发者先告诉它正在发生什么,再说明软件需要做哪种选择。结果可以是从几个标签里选一个、按标准打分,或判断某个条件成立的概率。TypeSafe 把这种面向机器的模型称为 System One,并称 Jev 是这个系列的第一个模型。官方发布说明
可以把它想成一位只负责分拣的助手。它看一眼来信,告诉系统“退款”“物流”或“需要复核”;后续由普通软件决定分到哪个队列、是否自动处理、什么时候通知人。Jev 给出判断,程序掌握动作
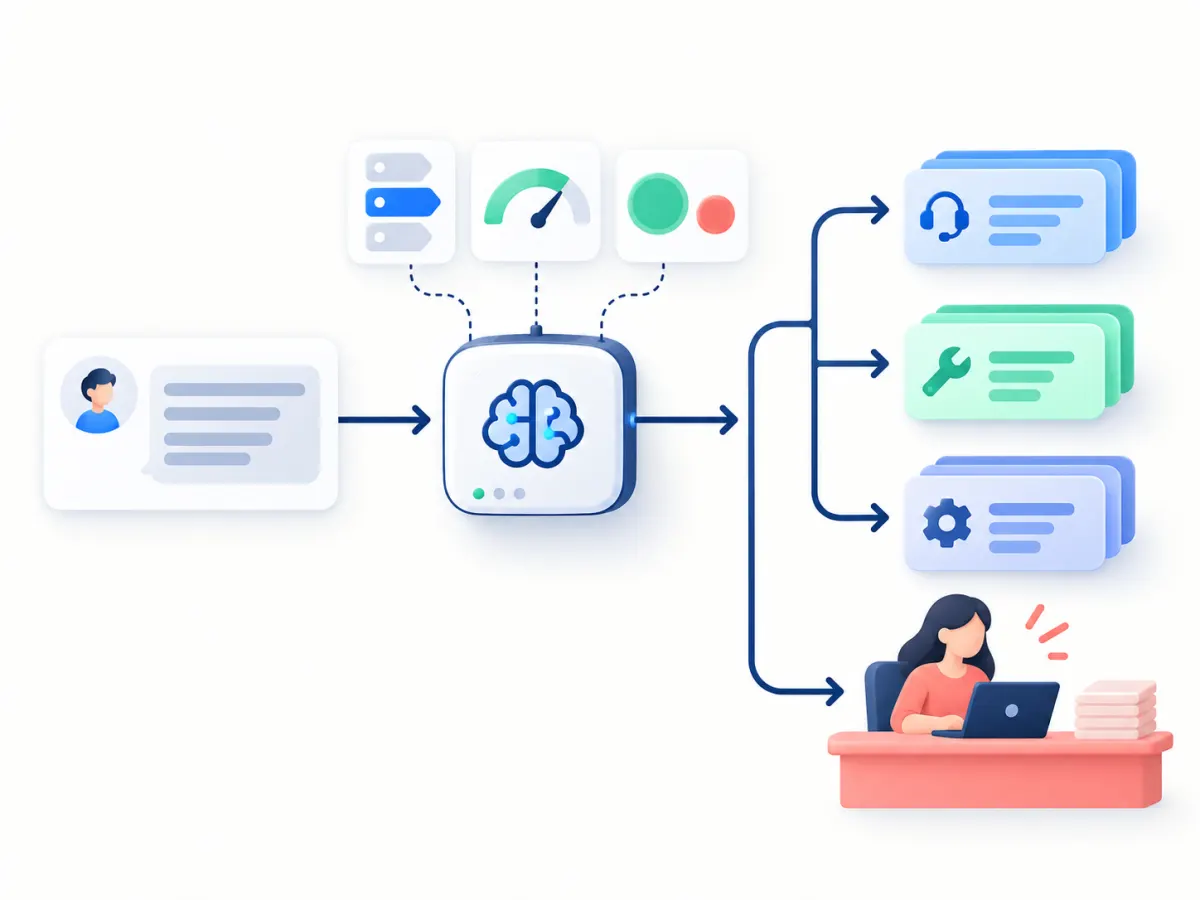
输入一段情境,模型返回预先约定类型的判断,程序再按结果分流
它的价值在大量细小判断里
单独判断一封邮件,并不值得专门换一种模型。麻烦在于,真实软件每天可能要做成千上万次类似判断:工单该交给谁,文章是否需要人工审核,哪些资料与搜索问题相关,一个智能体该调用哪个工具
这些任务有共同点:选项大致明确,判断重复出现,结果要交给程序继续处理。用一套手写规则覆盖所有说法很困难;每次都调用能写长文的大模型,也可能比任务本身需要的更慢、更贵
Jev 返回的选择和概率,可以让软件采取不同动作。判断很明确的工单直接进入对应队列;模型拿不准的邮件转给人工。内容审核可以先筛出高风险项,再由审核者检查边界案例。检索系统也可以让它给候选资料排序,而不是要求它把整份资料重新写一遍
这类设计不会让模型变成最终负责人。它把机器擅长的重复判断交给模型,把权限、计算和后续操作留在普通代码里;需要承担责任的边界,则仍可以留给人
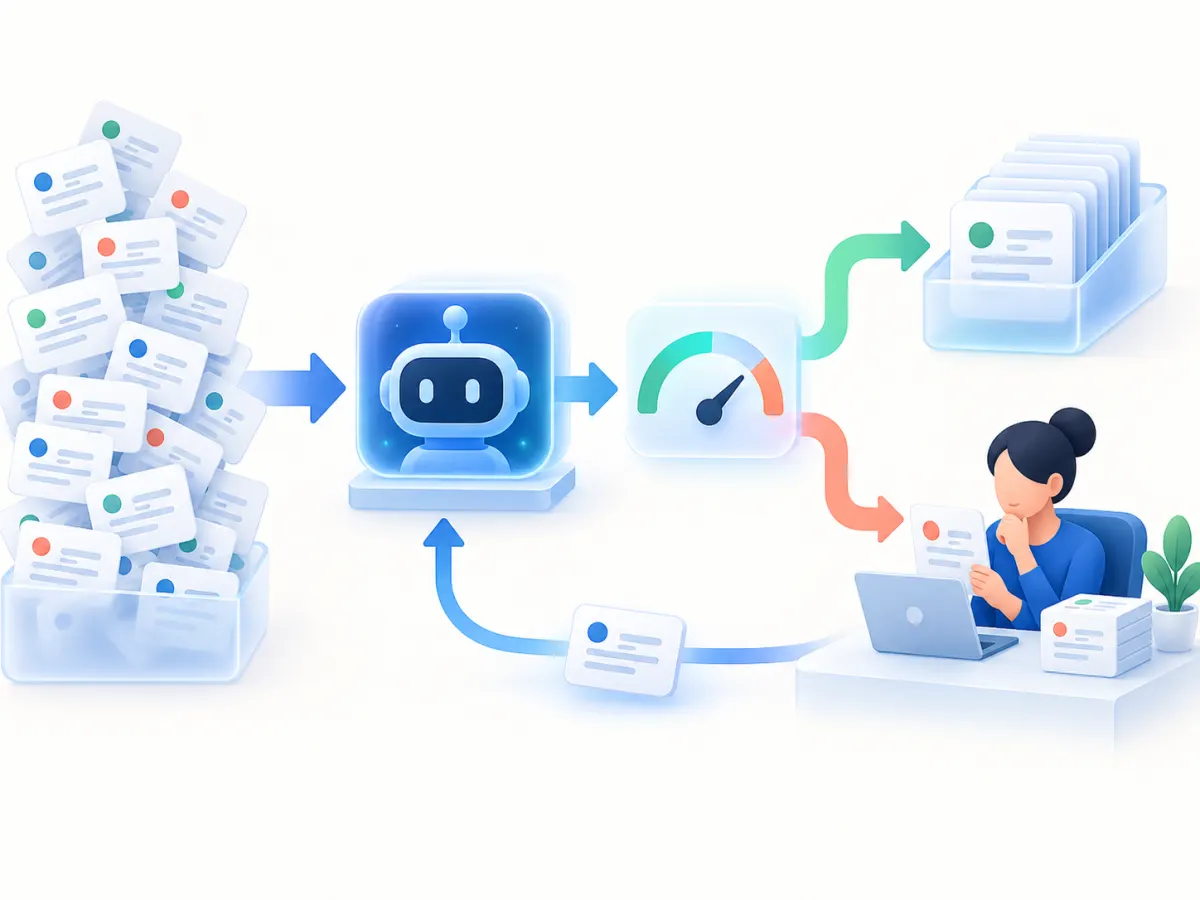
明确的判断进入自动流程,拿不准的项目转交人工检查
“不会幻觉”不等于不会判断错
TypeSafe 在发布介绍中强调,Jev 不生成任意文本,因此不会出现传统意义上编造一段答案的情况。这个说法需要分开理解:输出被限制在预先定义的结构里,确实能减少格式错误;但模型仍可能把一封邮件分错类,或者对错误答案给出很高的信心
信心分数的用途,是让系统知道何时自动处理、何时升级复核,不是给模型盖上“正确”的章。比如两个工单类别本身就很相似,模型即使给出了概率,分类标准的重叠仍可能造成误判。实际部署前,团队还得用自己的历史数据验证准确率,调整转人工的门槛
这一点也能从一项独立测试里看出来。AY Automate 用 791 条已标注判断任务比较 Jev 和四个通用模型,发现 Jev 在速度和成本上有优势,在分类准确率上大致接近小模型,但并没有全面胜过更强的模型;高置信度筛选能减少错误,却无法消除错误。测试方法和结果只覆盖几类公开任务,不能代替每个团队自己的业务评估
因此,TypeSafe 发布材料中的速度和成本倍数也不应直接理解成“任何任务都快几百倍”。模型是否划算,取决于输入长度、问题类型、候选数量、使用哪种对照模型,以及判断错一次要付出多大代价
它不是给所有人直接使用的聊天工具
Jev 目前面向把模型接入软件的开发团队,公开方式以 API 为主。它不适合让人直接交代“帮我写一封邮件”或“规划一次旅行”;这些任务需要生成文字、结合多步信息推理,仍更适合通用模型
普通用户短期内未必会打开一个 Jev 应用。但在后台,它可能让客服分流、内容审核、资料筛选这类小决定更快进入现有软件。对产品团队来说,真正值得试的做法不是立刻替换主模型,而是找出工作流里反复出现、选项清楚、出错后能复核的判断,再用自己的数据测试它
AI 模型过去常被当成会回答问题的对话对象。Jev 展示了另一种可能:模型也可以只是软件里一个专门作判断的部件
这条路能不能走远,还要看真实业务中的准确率、成本和复核设计。至少它提出了一个具体问题:一段自由生成的文字,真的是每个 AI 功能都需要的接口吗?