你有一批会议记录需要整理,也有一个改到一半的软件项目需要继续推进
前一个任务的步骤很清楚:提取决定、负责人和截止时间,再排成表格
后一个任务却要先读懂旧代码,追查错误来自哪里,修改几个互相影响的文件,完成后还得运行检查
过去,人们容易把这两件事都交给列表里最强的模型
9 月 22 日推出的 GPT-6 Sol 和 GPT-6 Luna,给出了另一种答案:模型不一定要选最强的,而要选与任务相称的
OpenAI 对两者的定位很直接
Sol 用于复杂编码和需要多步行动的工作,Luna 用于范围明确、重复频繁的大批量任务
它们正在 Codex 和 ChatGPT Work 中逐步开放,也可以通过 API 使用,但目前并不出现在普通 ChatGPT 对话里
两个模型对应两种工作节奏
把 Sol 和 Luna 理解成同一支团队里的两位同事,会比背参数更有用
Sol 更适合接住途中会出现分岔的工作,例如修复一个牵涉多个文件的错误、比较几种实现路线、阅读资料后形成完整方案
模型不能只执行第一条指令,还要根据工具返回的结果继续判断,必要时修改原来的计划
Luna 更适合处理边界清楚的任务,例如从几百份表单里提取固定字段、给用户反馈分类、批量修改格式、按相同规则检查一组文件
单次工作不一定简单,但流程能够重复,速度和成本就会不断累积成实际差异
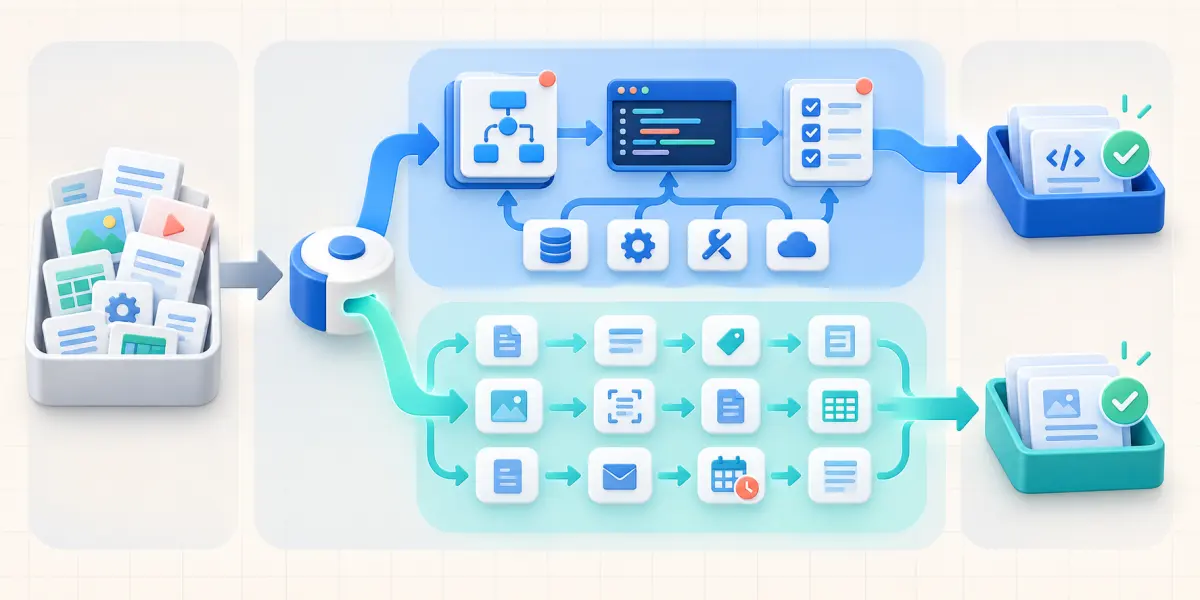
复杂任务沿着蓝色路径不断判断和验证,重复任务则从浅青色路径批量通过
这种分工不等于 Luna 只能做简单问答,也不等于 Sol 每次都会给出更好的答案
官方的模型选择说明把判断依据放在任务需要多少推理、等待时间和成本上,而不是给所有任务排一个固定名次
两者可以读取文字和图片,拥有约 105 万个 token 的上下文上限,也支持搜索、文件处理、代码执行和电脑操作等工具
真正拉开使用方式的,是你愿意为一次任务投入多少判断能力、时间和费用
价格差距,把模型选择变成了工作设计
截至 9 月 23 日,OpenAI 官方 API 价格的标准短上下文口径中,Sol 每百万输入 token 为 2 美元,输出为 10 美元;Luna 分别为 0.10 美元和 0.50 美元
按这个口径计算,两者的单价相差 20 倍
这个数字不能直接理解成“完成同一件事一定相差 20 倍”
一个更有判断力的模型可能少走弯路,用更短的输出完成工作
一次任务如果调用搜索、代码执行或其他工具,还会产生额外用量
超过 27.2 万输入 token 后,计费规则也会变化
单价只是选择的一部分,真正该比较的是完成任务的总成本和结果质量
但 Luna 的低价仍然改变了一个现实问题:过去舍不得反复调用模型的任务,现在更容易被自动化
每天整理一次客户留言,每小时检查一批格式,每次提交代码都做一轮固定扫描,这些动作单次看起来很小,乘上一整个月就不再小
把它们交给更轻的模型,可以把预算留给真正需要长时间判断的工作
普通用户不用先学会看参数
选择时可以先问四个问题
看看任务有没有多个互相影响的步骤,执行途中是否要根据新结果改变计划,错误结果会不会造成明显损失,以及你是否准备亲自检查最终内容
如果任务范围清楚、可以描述成固定规则,并且结果会经过人工复核,可以先试 Luna
整理文档、提取信息、初步分类和批量生成草稿,都属于容易开始的场景
如果任务会跨越多个文件或工具,需要在冲突信息之间取舍,或者失败后要自己找到原因再继续,Sol 更合适
复杂的软件修改、完整研究报告和多步骤工作流更接近这一类
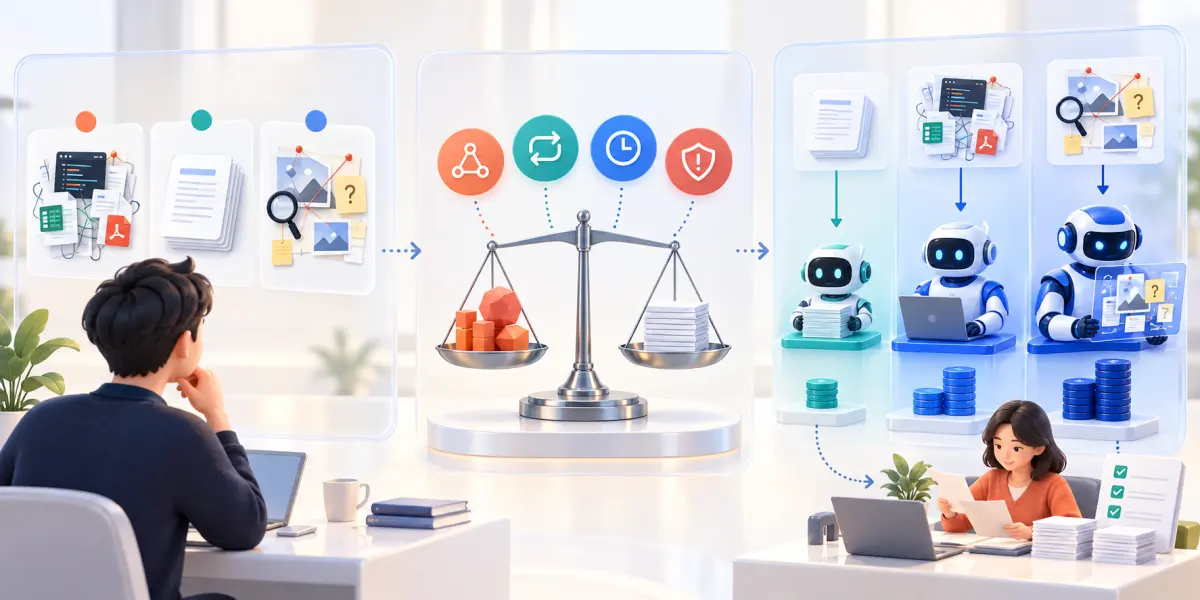
先看任务的复杂度、重复次数、等待时间和出错代价,再决定使用哪一档模型,最后保留人工检查
还可以先用 Luna 处理边界明确的前半段,再把少量疑难项目交给 Sol
例如先批量整理一百条反馈,再让 Sol 分析其中互相矛盾的十条
模型选择不必在任务开始前一次决定,也可以随着工作难度改变
现在还不能把选择完全交给 AI
Sol 和 Luna 已在 Plus、Pro、Business、Enterprise 与 Edu 计划中逐步开放,Free 和 Go 用户可以在桌面应用中使用 Luna
企业工作区还可能需要管理员开启,因此同一天里,不同用户看到的模型列表并不相同
具体可用范围应以官方更新记录和自己的模型选择器为准
它们目前接收图片,但不直接接收音频或视频,也不支持微调
对开发者来说,需要边推理边调用工具时,官方建议使用 Responses API;普通用户则不必为这些接口细节分心
更重要的限制来自任务本身
范围模糊、资料错误或缺少验收标准时,换一个更强的模型不会自动把问题变清楚
长上下文也只是允许放入更多资料,不代表每一条信息都会被同等准确地使用
这次发布真正值得关注的,不是模型列表又多了两个名字
AI 正从一个统一的万能入口,变成可以分配工作的计算资源
重复任务交给便宜、快速的模型,复杂任务交给更有判断力的模型,人负责设定边界并检查结果
学会拆任务,开始比一味追逐最强模型更重要