把一份长报告交给电脑里的 AI,屏幕迟迟没有出现回答 旁边的 iPhone 明明也有一颗能做计算的芯片,却只能陪着你等
如果用一根线把它们接起来,手机能不能替电脑分担一点工作?
开源项目 Backburner 就在尝试这件事 它让 iPhone 通过 USB-C 帮 Mac 运行本地模型,重点改善读取长材料的等待,并为更长的对话提供额外空间
这条路线的吸引力很具体,让已有设备一起工作 但接上线之后,收益取决于它们分到了什么任务
等待回答,可能是在等它读完材料
AI 回答长问题,需要先处理你交给它的资料,再逐步生成文字 前一个阶段通常叫预填充,可以理解成开口之前的准备工作
你只问一句“帮我起个标题”,准备的材料很少 如果先放进几十页报告、过去的讨论记录,再让它比较几个方案,这段准备就可能成为主要等待
Backburner 把部分准备工作拆给手机 在它默认的配置里,Mac 先处理一段计算,再把中间结果传给 iPhone 手机继续处理时,Mac 可以开始下一批材料,像两个人接力整理一摞文件
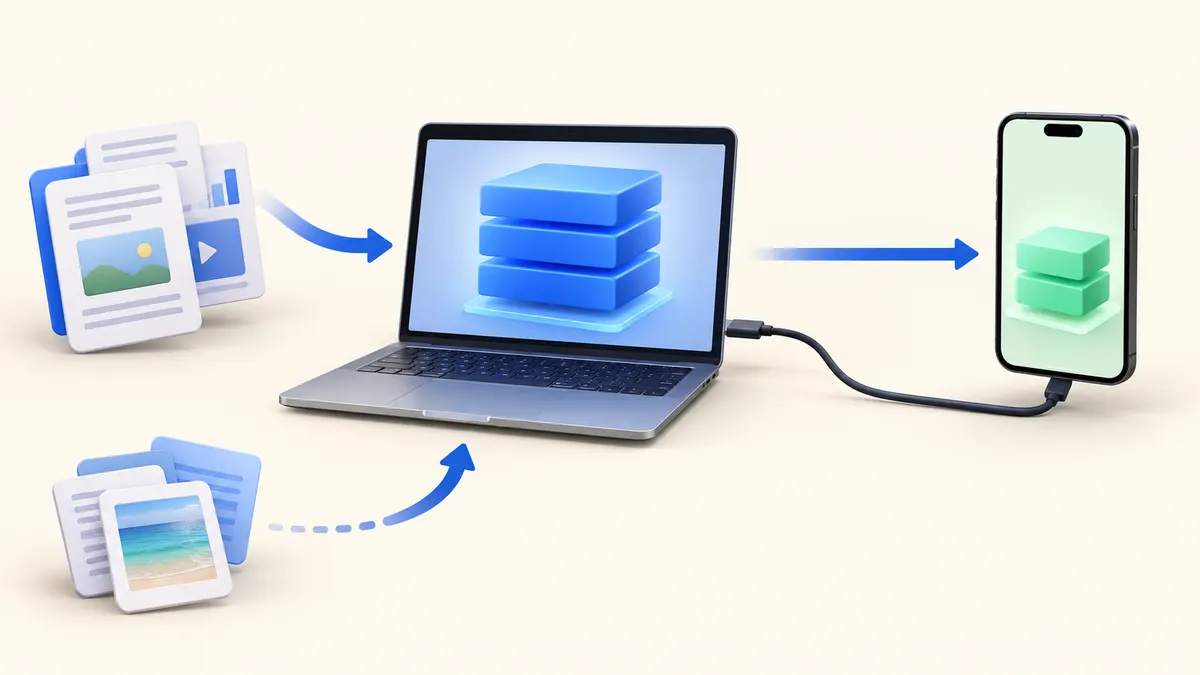
手机接着处理上一批,电脑准备下一批
这种分工需要传输数据,协调也有成本 因此项目让较小的读取任务留在 Mac,材料足够多时才请手机加入 多一台设备是否划算,要看省下的计算时间能不能抵过协作开销
读得更快,不代表回答也同比加速
维护者公布了 10 月 1 日的测试,使用 24GB 内存的 M4 Pro MacBook Pro、iPhone 17 Pro Max,以及压缩后的 Qwen3.8-27B 模型
在已经有一段长对话的情况下,再加入一份材料,接入手机后读取等待有所减少 但同一套引擎在部分测试里的文字生成速度,接不接手机几乎相同
收益主要发生在处理输入的阶段,不能把它理解成整个聊天过程都按同一比例变快
项目也修改了 Mac 上运行模型的引擎 比原版更快的部分,可能来自电脑自身的优化 要判断手机帮了多少,应该比较同一套引擎接入手机前后的结果
这些是项目方在指定配置下的测试,尚不能推导出每台 Mac、每个模型都有相同收益
手机还能替它留住一部分长对话
另一种麻烦发生在对话越来越长时 你前面交代过的背景、材料和中间结果,都要占用模型处理当前任务的空间,这通常叫上下文
Backburner 在对话超过一定长度后,会让手机保存较早部分的计算记录,并帮助电脑查询这些记录 此时手机的职责发生变化,重点转向分担长对话负担
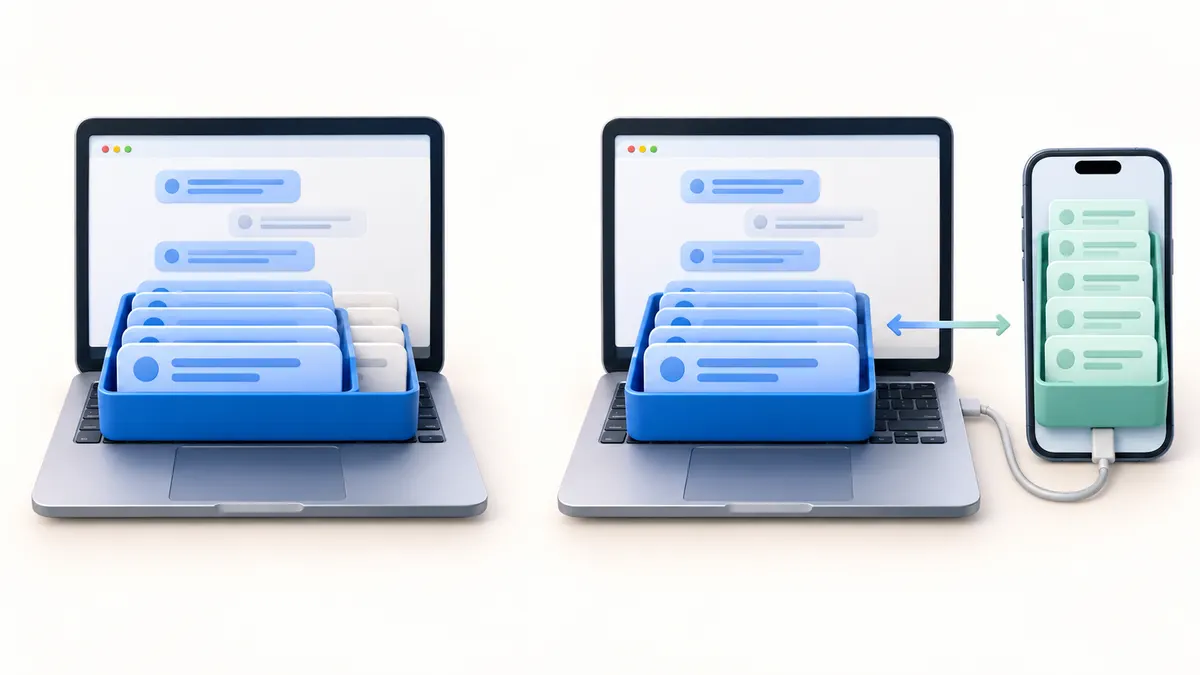
近期内容留在电脑,较早的计算记录由手机分担
这提供了容纳更多材料的机会,不过空间变大和理解更准确是两回事 能装下更长的记录,不保证模型每次都找得到关键细节,也不保证长报告的总结正确
这里的记录服务于正在进行的计算,不等于把聊天永久备份到了手机
它更适合资料多、来回处理的任务
准备一份项目复盘时,可以把多份会议记录交给本地助手,让它整理决定、待办和尚未解决的问题 如果等待主要耗在读取材料,设备协同就有尝试价值
比较几个产品方案时,也可以让助手带着前面的要求继续讨论,逐项找出差异 更大的上下文空间有助于减少反复补充背景,但关键结论仍要回到原文确认
对开发者来说,助手不断读取项目文件和工具结果,也属于这一类工作 每次读取节省的等待,可能在多轮任务里累积起来
这些是根据项目机制可以尝试的场景,效果还需要各自验证 如果只是偶尔聊几句,专门占住一部手机的收益就有限
先看门槛,再决定要不要插这根线
截至 10 月 6 日,项目仍标为预发布,使用 MIT 许可证 它需要 Apple 芯片的 Mac、兼容的 iPhone 和高速 USB-C 数据线 手机盒子里附带的线不满足项目要求,接头相同不代表传输能力相同
手机应用也需要额外安装 安装文档给出了 AltStore 和 Xcode 两条路线,但注明 AltStore 路线尚未由维护者完整实测,免费账户签名还需定期刷新
长对话下,手机保存着电脑需要的计算记录,应用必须保持前台运行 锁屏、切到别的应用或拔掉线,可能让服务停止 这会影响你同时用手机处理其他事情
本地运行减少了把材料交给云端模型的需要,仍要检查所接入工具的数据流向 项目的安全说明还提醒,早于 0.0.3 的手机应用曾接受更宽泛的网络连接,试用应先更新版本
已经拥有兼容设备、愿意配置本地模型的人,可以拿一份不敏感、自己读过的长材料做对照 用相同模型和任务,比较接入手机前后的等待,再检查回答质量
暂时没有必要为了它购买新手机 Backburner 提供了一个值得观察的思路,把手边设备的计算能力组织起来 当等待来自读取长材料和容纳长对话时,旁边的手机才更可能帮上忙