你记得读过一篇文章,里面有个观点正好能用在今天的工作里,翻完收藏夹和下载目录,却只找到一堆眼熟的标题
把文章交给 AI 总结,能省下一次阅读的时间 但过了两周,哪篇支持这个观点、哪篇提出反例,还是得重新找
开源桌面工具 LLM Wiki 尝试接手这段整理工作,让 AI 把文档写成相互链接的百科页面,再随着新资料加入继续更新 你留下的东西,从一摞文件变成了一本可以翻阅、追问的个人百科
收藏之后,还缺一位整理员
想象你在研究一个行业,陆续存下报告、公司介绍和访谈笔记 按文件名建目录,只能帮你把它们放好;想知道某家公司有哪些产品、几份报告为什么意见不同,仍要跨文件阅读
LLM Wiki 的做法是围绕资料里的公司、概念和问题建立页面,把相关内容连起来 原始材料保留在资料区,AI 写出的摘要和关联放进另一个可浏览的知识库
这套思路来自 Karpathy 的 LLM Wiki 设计,桌面应用由 nash_su 实现和维护 最近的 v0.6.12 发布于 9 月 28 日,它并非今天才出现的新品,但提供了一个具体的观察窗口,让人看到 AI 如何参与长期资料整理
它最有用的地方,是让整理结果留得下来,下一次还能继续用
新资料进来,旧页面也要跟着改
按项目说明,导入资料后,AI 先分析其中的对象、观点,以及它与已有页面的关系,再生成摘要、概念页面和交叉链接,并更新目录
假设你已经整理了几份关于电池寿命的材料,又加入一篇讨论低温影响的报告 理想的结果包括一份新摘要,以及对原有“电池寿命”页面的补充,让下一次阅读能同时看到相关条件
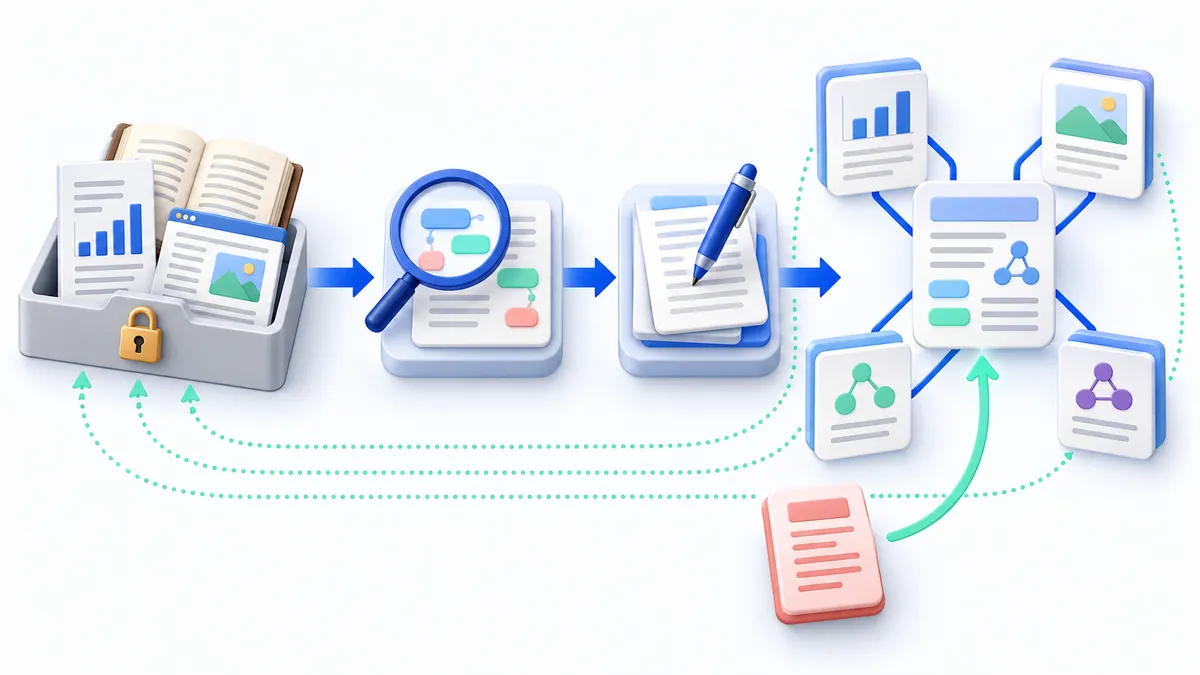
原始资料保留,分析与写入分步进行,新材料继续补充已有页面
这种变化容易被说成“取代检索”,但这个桌面项目依然会搜索资料和页面,也提供可选的语义搜索 改变的是整理发生的时间,部分跨资料的归纳被提前写进知识库,提问时可以拿来继续讨论
代价也跟着前移 导入时要等模型处理、检查生成结果;资料经常变动,知识库也需要维护 如果只是问一份短文档里的某个数字,直接搜索原文可能更省事
从一本书、一个专题开始,比导入整个硬盘有用
读一本非虚构书时,可以把章节笔记放进同一个项目,围绕书里的概念逐步整理 等读到后面,再追问“这个说法和前几章有什么联系”,同时回到原文检查,避免只留下几份互不相干的章节摘要
做长期专题时,可以收集几篇围绕同一问题的报告,把支持观点、反例和适用条件分别看清楚 比如研究远程办公,把“适合哪些岗位”和“怎样衡量效果”分开,后续材料就有了明确的整理方向
工作交接也能借用这个思路,把经过授权的会议记录和项目说明整理成可查的主题页面 项目支持 PDF、Office 文档和网页剪藏等输入,但不同文件的解析质量会影响后续整理,不宜把生成页面直接当作正式制度
这些场景都有一个共同点,资料会持续增加,人会反复回来使用它们 一次性的旅行查询或临时问答,未必值得维护一本百科
页面之间有链接,不代表结论就正确
AI 可能把条件不同的观点合并,把作者的猜测写成确定的解释 错误一旦进入概念页面,后续问答就可能沿用它
项目为生成页面保留来源字段,也提供人工审核入口和只依据原始资料回答的模式 这些能力方便核对,但有出处只能帮助找到材料,不能保证归纳准确
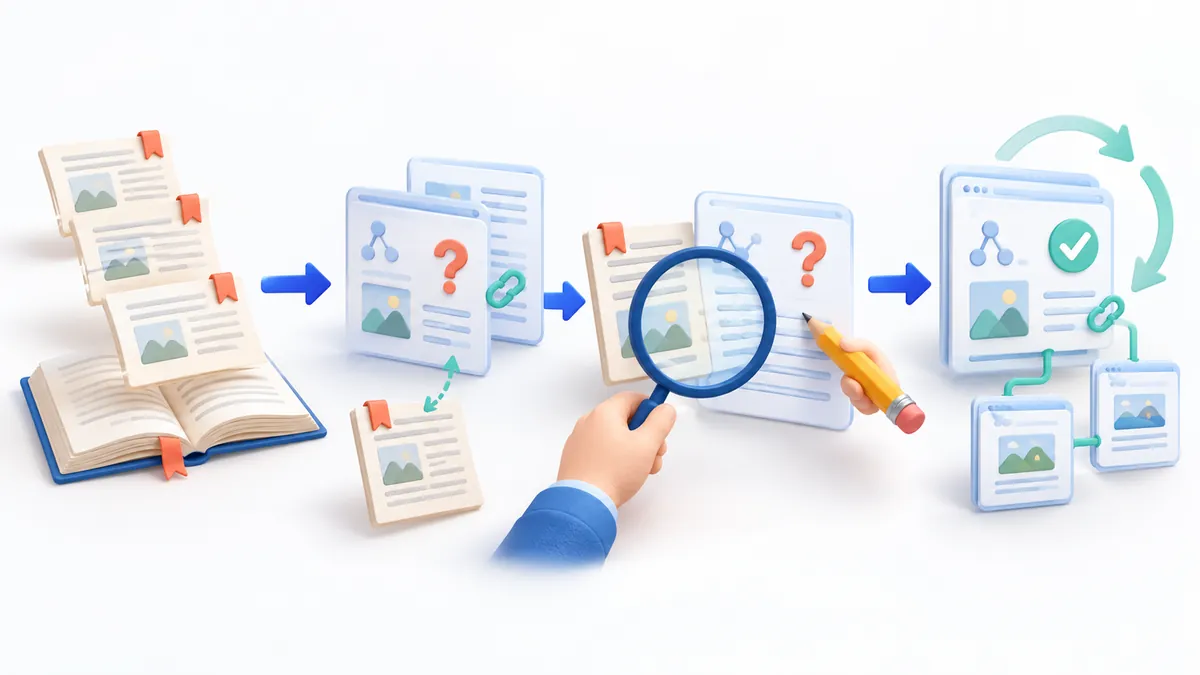
发现可疑归纳后,回到章节原文核对,再决定怎样修改页面
比如两个报告都提到“效率提升”,先检查它们测的是处理速度还是最终产出,再看对象和条件 把它们连起来是整理工作,判断能否放在一起比较,仍需要人
知识库里的关联越丰富,越应该保留这种区分 否则收藏夹里的杂乱,只是换成了排版整齐的误解
先让几份资料用起来
LLM Wiki 使用前需要配置模型,接入云端服务可能产生费用,也会把相关内容发送给服务商 文件保存在电脑里,不代表整个过程都在本地完成,敏感资料要先确认能否使用
想试试,可以从下载页面开始,挑几份自己读过、不含敏感信息的材料,看看它能否帮你找回出处、串起观点
先让一个小专题用起来,再决定要不要扩大 收藏的价值,也就在下一次需要时,能找到并用上它