每天盯几十个行业账号,难处常在于同一件事被不同媒体反复转述,真正值得行动的变化反而被淹没
最近开源的 AIHOT 想处理的正是这类工作:它把新闻来源、筛选标准和摘要流程组合成一个可以改造成自己行业的网站框架
AIHOT 把筛选规则摊开,让懂行业的人可以自己定义什么值得留下。它不会替行业专家决定热点,作用是按设定好的标准持续整理消息
它把多篇报道归成事件
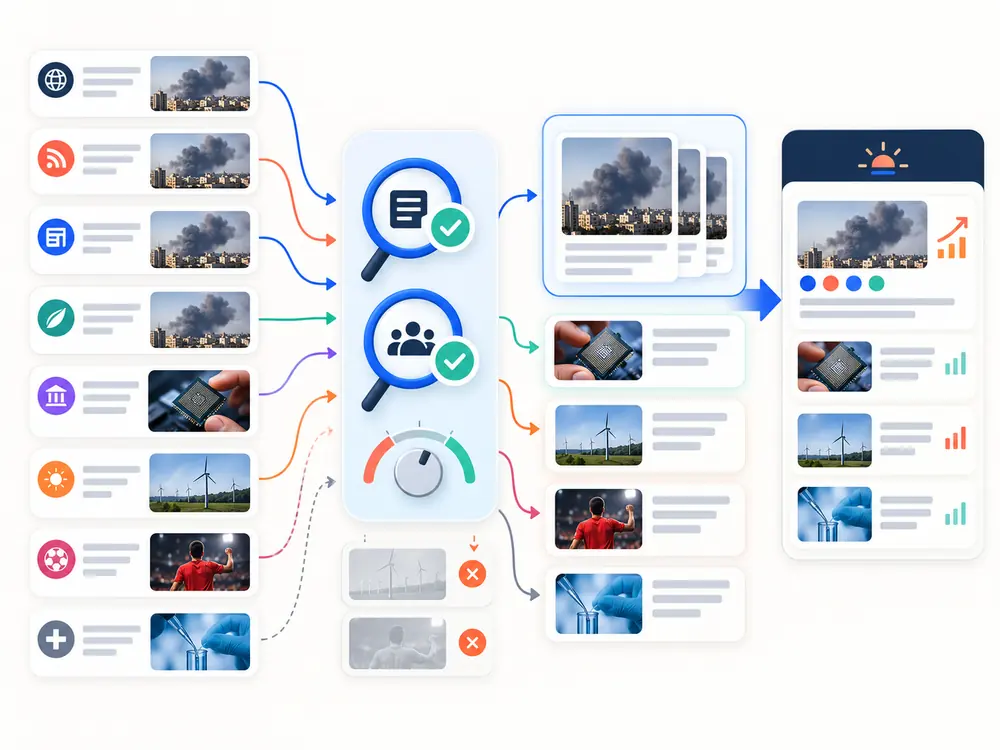
普通资讯聚合器会把每篇报道排成一条。AIHOT 先收集文章,再判断是否重复、是否相关、是否值得读;通过筛选的内容会被改写成中文标题和摘要,来自不同来源的同一件事则归到一起
比如某家芯片公司发布新品,官网、媒体和社交账号可能连续出现多条内容。AIHOT 会尽量把它们收拢成一个事件,再根据独立来源数量计算热度,减少转载数量对排序的影响
真正的配置项,是行业知识
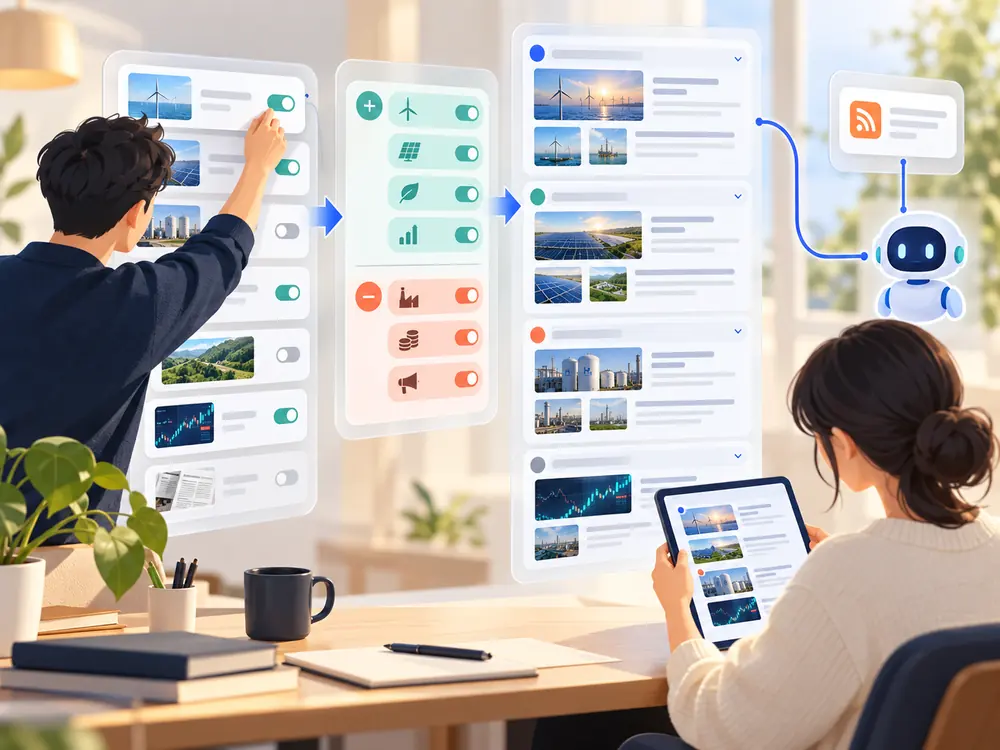
AIHOT 把信源、分类、筛选提示和入选门槛集中放在行业配置里。换句话说,法律团队可以盯法规与判例,能源研究者可以关注政策、项目和价格变化;筛选词和标准也能随行业调整,而不必从头开发整套网站
安装完成后,模型仍需要你提供行业判断。你要挑选信源、讲清楚哪些变化重要、哪些只是噪声,再用自己标注过的样本检查筛选结果。项目文档建议用一两百条资料做校准,这一步是把团队经验写成机器能反复执行的规则
小型研究团队可以用它把政策网站、协会更新和几家媒体汇成晨间简报;行业编辑可以先整理事件线索,再核实原文、补上背景,减少从头翻找重复消息的时间。这些场景适合作为试用方向,项目尚未提供真实团队的验证案例
内容还能通过 RSS、公开接口和 MCP 提供给订阅器或 AI 助手,让一份筛选结果同时供人阅读和其他工具查询。AIHOT 提供了一条可自行改造的资讯生产线,使用者需要自己完成配置和维护
运行仍有部署与数据成本
运行项目需要 Docker 和兼容的模型 API 密钥。网站部署在自己的机器上,如果模型服务使用云端 API,文章内容和筛选提示仍需交给对应服务处理;自行部署网站无法保证模型调用也留在本地
还要留意项目自己的说明:当前公开仓库是线上代码的一份快照,不保证和之后的线上版本同步;示例只带了公开的 AI 资讯源,不包含 AIHOT 实际使用的完整来源名单和运营数据。代码采用 MIT 许可,但项目名称和 Logo 不包含在许可范围内
所以更适合愿意折腾部署、手上已有可靠信源、并能投入时间校准标准的开发者或小团队。如果只是想每天少看几条新闻,直接订阅现成资讯服务会省心得多;如果你有稳定的信息筛选流程,却被重复消息拖慢,AIHOT 值得拿一个窄行业先试
可以先写下五个最信任的来源,再列出三条“什么消息必须进简报”的标准,人工挑三十条旧资料试着分类。先把取舍规则说清楚,再交给 AIHOT 持续执行,后续才有依据检查筛选效果、逐步调整标准